SRT字幕乱码修复:自动识别编码,一键转成 UTF-8
SRT字幕乱码几乎都是编码对不上:文件按一种编码保存,软件却按另一种编码去读。把乱码的 .srt 拖进下面的工具,它会分别按 UTF-8、GBK、Big5、UTF-16 解码,把几种结果并排给你看,每种都附一个可读性评分;你选中文字正常的那一种,一键另存为 UTF-8(可选带 BOM),再导入剪映、Premiere 或播放器就不会乱。工具不替你硬猜,最后由你确认;文件只在浏览器里处理,不会上传。
- 四种编码并排预览
- 另存 UTF-8 / 带 BOM
- 可批量
- 文件不上传
更新于 2026 年 11 月 5 日内容核对于 2026 年 11 月 5 日
episode-01.zh.srt
UTF-81
00:00:00,400 --> 00:00:06,900
订婚宴的香槟塔刚刚搭好,苏念猛地睁开眼——她回到了被陷害的那一天。
2
00:00:07,100 --> 00:00:12,000
妹妹,这份股权转让书签了吧,大家都在等你呢。
3
00:00:12,200 --> 00:00:16,600
签?姐姐不如先看看,大屏幕上放的是什么。
4
00:00:16,800 --> 00:00:22,100
灯光一暗,监控录像里,苏曼正把药粉倒进她的酒杯。
5
00:00:22,300 --> 00:00:24,500
关掉!谁让你们放的!
SRT字幕乱码修复:拖入文件,选能读的那一种
可以一次拖入多个字幕或文本文件,单个文件最大 10 MB。每种编码的解码结果和评分并排显示,选好后下载 UTF-8 版本。
SRT字幕乱码怎么解决:四步转成 UTF-8
不用安装软件,也不用懂编码原理。修SRT字幕乱码之前,原文件先留一份备份,修好的版本会另外下载。
- 01
拖入乱码的文件
把 .srt 或其他字幕、文本文件拖进工具,可以一次拖多个,单个文件最大 10 MB。文件开头有 BOM 的,工具会先按 BOM 认出 UTF-8 或 UTF-16。
- 02
看并排预览和评分
同一份文件分别按 UTF-8、GBK、Big5、UTF-16 解码,几种结果并排显示。评分综合了两件事:解码后出现多少替换字符“�”,以及常用汉字占多大比例。分数最高的通常就是对的,但请用眼睛再确认一遍。
小贴士 · 看人名和常见词最快:哪一栏里“姐姐”“订婚宴”这种词是通顺的,就选哪一栏。
- 03
选中正常的那一种
点选文字通顺的那一栏。如果整份文件里只有少数几行不对,可能是两个来源的字幕被拼在了一起,工具会按行标出可疑的行,你可以只回去核对这几行。
- 04
另存为 UTF-8
下载转换后的文件,编码是 UTF-8。要导入 Windows 上的老软件,勾选“带 BOM”和“CRLF 换行”;用于网页播放器或脚本处理,保持默认的无 BOM 即可。
SRT字幕乱码长什么样:从样子反推原因
不同的编码错位,会让SRT字幕乱码留下不同的“指纹”。下表里的例子都是我们用真实的编码转换算出来的,原文是“你好”“我回来了”“字幕乱码”。
| 你看到的样子 | 例子 | 发生了什么 | 能不能救 |
|---|---|---|---|
| 一串生僻字,看着像中文但读不通 | 浣犲ソ、瀛楀箷涔辩爜 | UTF-8 文件被当成 GBK 读 | 能:在工具里选 UTF-8 |
| 问号、黑色方块 �,夹着零星怪字 | ���、��Ļ���� | GBK(ANSI)文件被当成 UTF-8 读 | 能:选 GBK |
| 带重音符号的拉丁字母 | ä½ å¥½、å—幕乱ç | UTF-8 文件被西文软件按 Windows-1252 读 | 能:选 UTF-8,另存时带 BOM |
| 像繁体字,但完全不成句 | 扂隙懂賸(原文“我回来了”) | GBK 文件被当成 Big5 读 | 能:选 GBK |
| 字与字之间夹空格或方块,数字隔一个字一个 | 1 0 0 : 0 0 : 0 1 | UTF-16 文件被按单字节编码读 | 能:选 UTF-16 |
| 成串的“锟斤拷” | 锟斤拷锟斤拷 | 原字节已被替换字符覆盖后又保存 | 大多不能 |
| 只有第一行开头多出几个怪字 | 、锘 | UTF-8 的 BOM 被不认 BOM 的程序当成了文字 | 能:另存为无 BOM 的 UTF-8 |
GBK、Big5、UTF-8、UTF-16 分别是什么
- GBK(以及它的扩展 GB18030):简体中文 Windows 的本地编码,记事本和很多老软件里叫“ANSI”。网上下载的老字幕、字幕组早年的文件很多是它。
- Big5:繁体中文的传统编码,常见于台湾、香港来源的老字幕。
- UTF-8:现在最通用的编码,网页、手机和大多数新软件默认用它,一个文件里能同时放中文、英文、泰文、日文。
- UTF-16:每个字符至少两个字节,旧版 Windows 记事本里叫“Unicode”。英文和数字之间会多出零字节,所以按单字节编码读时会出现“隔一个字一个”的样子。
- 工具只提供以上四种解码。西欧语言常用的 Windows-1252、泰语的 Windows-874 等其他老编码不在其中,这类文件要用能指定编码的文本编辑器另存为 UTF-8。
UTF-8 要不要带 BOM
BOM 是文件开头的三个字节(EF BB BF),作用是告诉软件“这是 UTF-8”。Windows 上不少软件靠它来认编码,没有 BOM 就按本地的 GBK 去读,于是出现SRT字幕乱码;反过来,一些严格的程序不认 BOM,会把这三个字节当成第一行的文字,第 1 条字幕的序号就读不出来,或者开头多出“”。所以导入剪映、Premiere、Windows 播放器时选带 BOM,给网页播放器、命令行工具或代码处理时选无 BOM。AI Drama Voice 配音导出的 SRT 就是带 BOM 的 UTF-8,换行用 CRLF。
常见软件里和编码有关的设置
| 软件 | 和编码有关的地方 | 建议 |
|---|---|---|
| Windows 记事本(Windows 11) | “另存为”窗口底部的“编码”可选 ANSI、UTF-16 LE、UTF-16 BE、UTF-8、带有 BOM 的 UTF-8 | 只在文字显示正常时另存,否则会把乱码原样存下来 |
| 剪映专业版 / CapCut | 中文字幕按 UTF-8 准备最稳,带 BOM 的 UTF-8 可以直接导入 | 导入前先转成 UTF-8;导入步骤见剪映配音对齐教程 |
| Premiere Pro | GBK(ANSI)编码的 SRT 是导入后乱码最常见的来源 | PR 导入 SRT 字幕乱码时,先转成带 BOM 的 UTF-8 再导入 |
| VLC | 偏好设置 → 字幕/OSD → 默认编码,可以指定 GBK、Big5 等 | 只影响 VLC 播放,不改文件 |
为什么“锟斤拷”这种双重乱码大多救不回来
前面几种SRT字幕乱码,原始字节都还在,只是被读错了,换一种读法就能复原。“锟斤拷”不一样:字节本身已经被改掉了。
过程是这样的:一份 GBK 的字幕被某个软件当成 UTF-8 打开,它看不懂的字节全部被换成替换字符“�”;接着有人点了保存,文件就按 UTF-8 写下了一串“�”。之后再有软件按 GBK 去读,每两个“�”的字节正好拼成“锟斤拷”。我们拿“你好,姐姐”试了一遍,最后得到的是“锟斤拷茫锟斤拷锟斤拷”,原来的字已经无从反推。
- 先找有没有更早的原文件:网盘、聊天记录里的附件、剪辑工程旁边的备份。
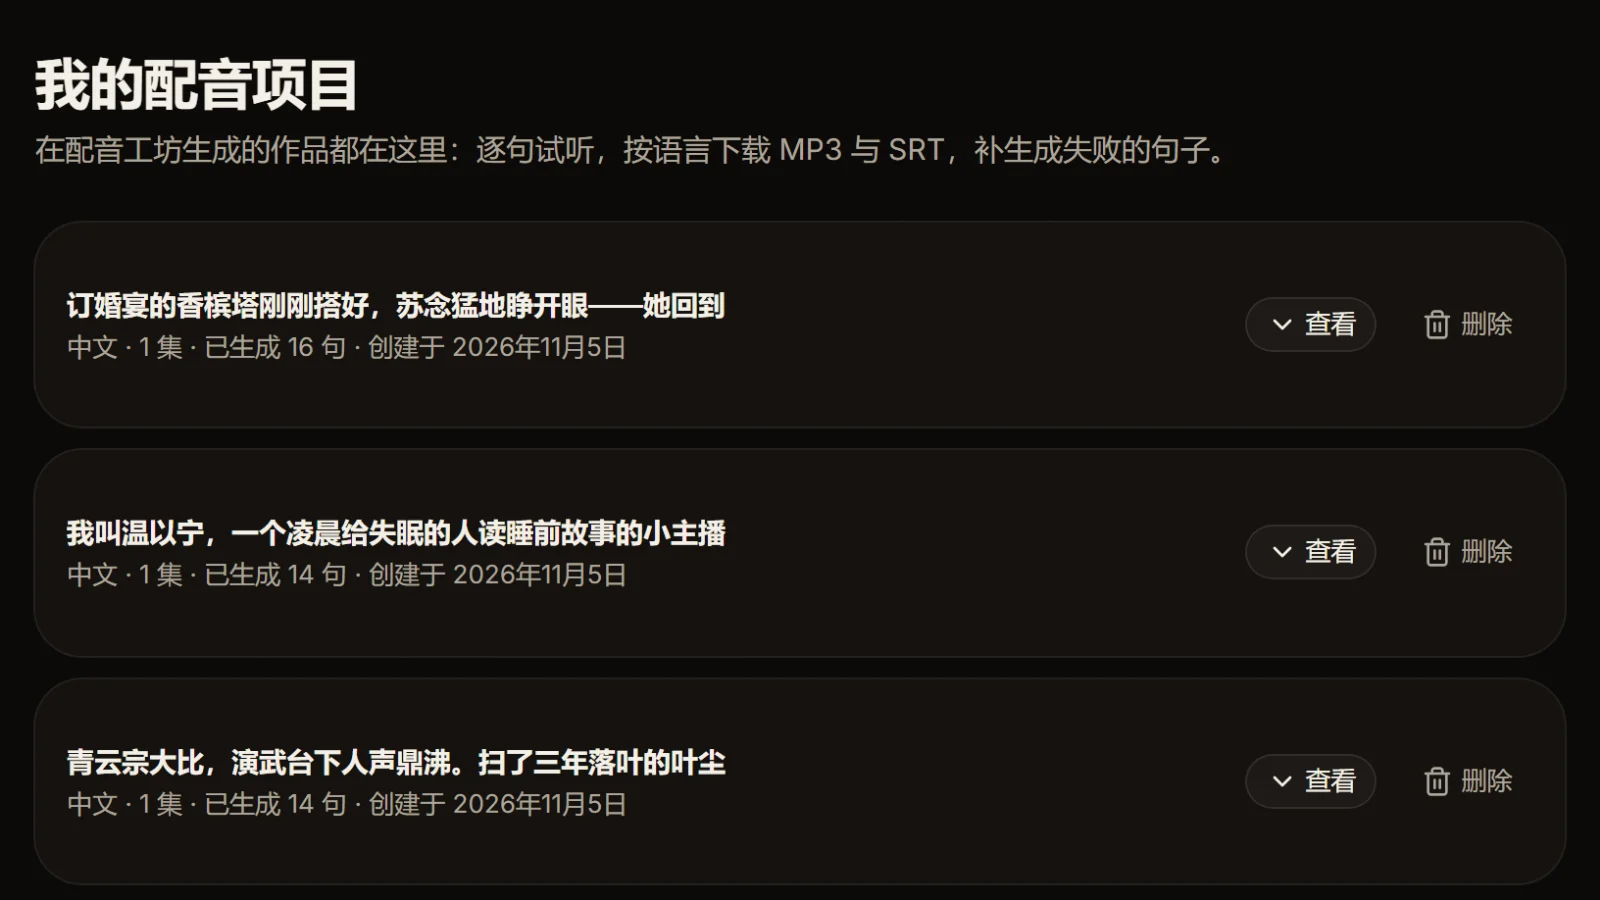
- 字幕是你自己配音导出的,直接到“我的配音项目”里重新下载一份。
- 只有台词稿的,用 TXT转SRT 重新生成一份字幕,或者重新配音时一起导出。
- 以后改字幕前先复制一份原文件,在文字显示正常的情况下再另存。
记事本另存为 UTF-8 还是乱码?
多半是打开时就已经显示成乱码了,另存只是把乱码原样存成了 UTF-8,这本身就是一次“双重乱码”。正确顺序是:先用本工具找到文字正常的那种编码,再另存。
以后少碰 SRT字幕乱码的六个习惯
交付统一用 UTF-8
团队之间传字幕、上传平台,一律用 UTF-8。要给 Windows 上的老软件用,再另存一份带 BOM 的。
别用 Excel 打开 SRT
表格软件会按自己的规则改写换行和编码,保存后结构和编码都可能坏掉。要表格,用 SRT转TXT 导出 CSV。
改之前先备份
乱码是可以救的,前提是原始字节还在。任何编辑之前先复制一份,修坏了还能从头来。
繁体来源先试 Big5
台湾、香港来源的老字幕,在工具里先看 Big5 一栏;简体来源的老字幕先看 GBK 一栏。
方框不一定是编码问题
泰语、越南语、韩语显示成方框,多数是字体缺字。在剪映或 PR 里给字幕换一个支持该语言的字体,比反复转码有效。
一季字幕一次处理
一次拖入整季的文件,逐个确认编码后批量下载,统一成 UTF-8,后面导入剪映、做时间轴调整都省事。
常见问题
SRT字幕乱码几乎都是编码不一致:文件用 GBK、Big5 或 UTF-16 保存,软件却按 UTF-8 读,或者反过来。少数情况是文件被错误保存过(“锟斤拷”),或者字体里没有这种文字(显示成方框)。
PR 导入 SRT 字幕乱码,多数是文件不是 UTF-8。把文件拖进本工具,选文字通顺的那一种编码,勾选“带 BOM”另存为 UTF-8,再导入 Premiere。如果只有泰语、韩语等显示成方框,换一个支持该语言的字体。
导入剪映、Premiere、Windows 上的播放器,选带 BOM,软件更容易认出 UTF-8;给网页播放器、命令行工具或代码处理,选无 BOM,避免第一行开头多出怪字。拿不准就先试带 BOM。
通常是记事本打开时就已经读错了编码,另存只是把乱码原样存了下来。回到原文件(没被另存过的那份),用本工具找到显示正常的编码再转换;原文件已经被覆盖,就只能找备份。
大多数情况下不能。出现“锟斤拷”说明原来的字节已经被替换字符覆盖并保存过,信息已经丢失。只能找更早的原文件、重新下载,或者用台词重新生成字幕。
正常不会:AI Drama Voice 导出的 SRT 是带 BOM 的 UTF-8,换行是 CRLF,剪映、Premiere 都能直接读。如果乱了,多半是在别的软件里另存过;泰语、韩语显示成方框则是字体问题。也可以到“我的配音项目”里重新下载。







