TXT分割器:小说按章节或字数切开,一集一个文件
TXT分割器把一整本小说 TXT 切成一份一份的小文件:可以按「第X章」这类章节标题切,也可以按字数切,而且只在句号、问号这类句末断开。它内置了配音工坊的单集上限——8,000 字(不计空白)、400 行:选「按章合并」时,相邻的短章会并成不超过上限的一份,超长的一章在句末拆开,每份都标出字数和行数。GBK、Big5 编码的老 TXT 能自动识别,切好的文件统一存成 UTF-8,打包成 ZIP 下载。整个过程在你的浏览器里完成,文件不上传。
- 按章 / 按字数
- 内置一集 8,000 字
- 自动识别 GBK
- 文件不上传
更新于 2026 年 11 月 6 日内容核对于 2026 年 11 月 6 日
样片 C · 冷宫里的一壶毒酒
中文 · 台词节选 · 3 个角色


旁白
第一章 冷宫雪
旁白
永安十二年冬,第一场雪落进冷宫时,沈知微已经在这里住了整整三年。
旁白
院门被推开,来人披着白狐裘,是如今最得宠的柳贵妃。

柳贵妃冷笑
姐姐还是这般清高。本宫有喜了,特来请姐姐喝一杯喜酒。
TXT分割器:打开小说,先看章节再切
选一个 TXT(最大 50 MB),再选切法。工具会先列出识别到的章节标题让你确认,然后给出每一份的字数和行数,超过 400 行的标红,确认后打包 ZIP 下载。
TXT分割器怎么用:四步切完一本小说
不用装软件,也不用会正则。第一次用,建议拿一本你熟悉的书试一遍,看看章节列表认得准不准。
- 01
打开 TXT 或粘贴文本
选一个 .txt 文件(最大 50 MB),或者直接把文本粘贴进来。工具会自动判断编码:UTF-8、GBK、Big5 都能认,预览里汉字显示正常,就说明读对了;拿不准的时候会提示你。
小贴士 · 预览还是乱码,说明文件用了更少见的编码。先用记事本「另存为」UTF-8,再打开一次。
- 02
选一种切法
「按章合并」是默认的切法:先按章切,再把相邻的短章并到上限以内,上限默认就是工坊一集的 8,000 字,并且同时守住 400 行。另外两种:「按章」一章一份,可以选择把超过字数上限的章在句末拆开;「按字数」每份接近你设的字数,优先在段落结尾、其次在句末断开。
- 03
确认识别到的章节标题
切之前,工具会把认出来的每个标题列出来,每个前面都有勾选框:误认的取消勾选,漏认的勾上别的预设或写一条自定义正则。编号不连续的(第 12 章后面直接是第 14 章)和下面没有正文的(目录页、卷名)会单独标出,没有正文的可以一键取消。整本书一个标题都认不出时,自动退回按字数切。
- 04
看每份字数,下载 ZIP
结果表列出每一份的字数(不计空白,和工坊的算法一样)和行数,超过 400 行的标红。每一份都能单独复制或下载,也可以整包下载 ZIP:里面每个文件都是 UTF-8 编码,按「序号-章节名.txt」命名,比如「001-第一章 雪夜.txt」,序号就是集数。
TXT分割器为什么默认按 8,000 字切
这个数字不是随便定的:它就是 AI Drama Voice 配音工坊一集能放的量。切出来的一份,正好贴进工坊配成一集。
工坊一集的两条上限
第一条是 8,000 字。工坊数字数时去掉所有空格和换行,标点照算;在工坊里直接上传一个超过 8,000 字的 TXT,会被拒绝。第二条是 400 行:工坊一行配一句,对白密的章节行数涨得比字数快。算一笔账就明白——400 行 × 20 字正好 8,000 字,平均每行不到 20 字的章节,会先碰到行数上限。所以 TXT分割器在结果表里同时给出字数和行数,超过 400 行的那一份标红。
同一本书,三种切法切出来什么样
假设前五章(不计空白)分别是 3,100、2,800、4,600、2,400 和 9,300 字,一共 22,200 字。三种切法的结果差别很大:
| 切法 | 切出来的份数 | 问题或好处 |
|---|---|---|
| 按章 | 5 份:每章一份 | 第 5 章 9,300 字,超过一集的上限;前四章每份都不满,配成五集长短不一 |
| 按字数(8,000) | 3 份:前两份各接近 8,000 字,第三份是剩下的 | 每份都满,但分界多半落在章节中间,第二集、第三集都从某一章的半中间开始 |
| 按章合并(8,000) | 4 份:第 1–2 章 5,900 字;第 3–4 章 7,000 字;第 5 章拆成两份大致等长的 | 每集都从章首开始,没有一份超限,适合一份配一集 |
按字数分割文本:只在句末断开
按字数切时,TXT分割器不会在设定的那个字上硬切。一份快满的时候,它先往回找段落结尾,在那里断开还能保留八成五以上的字数,就断在段落结尾;不然就断在最近的句末——句号、问号、叹号、省略号,句末的后引号跟着前一句走。所以每一份通常比设定值少一点,但不会有半句话被切到下一集。唯一的例外是一句话本身就比上限还长(比如整段没有句号),这时只能在逗号、分号处断开,这一份会单独标出来。配音时这一点很重要:一句台词被拆成两半,会落到两集里,前一集的结尾和后一集的开头都读不通。
编码、文件大小和文件名
从网上下载的老 TXT 很多是 GBK 编码,用支持 UTF-8 的软件打开就是乱码。TXT分割器读文件时自动在 UTF-8、GBK、Big5 之间判断,导出时一律写成 UTF-8,剪映、工坊和手机阅读器都能直接读。50 MB 的上限按 GBK 算(一个汉字 2 个字节)大约是两千五百万字,按 UTF-8 算(一个汉字 3 个字节)大约一千七百万字,一般的长篇放得下。导出的文件名是「序号-章节名.txt」,序号至少三位(001、002……),合并的几章写成「第一章 ~ 第二章」,文件名里 Windows 不允许的字符会换成空格,在文件夹里按名字排序就是阅读顺序。
txt小说分章:章节标题怎么才能认出来
小说章节分割器好不好用,全看标题认得准不准。TXT分割器的预设覆盖了常见写法,特殊写法用自定义正则补上。不管哪种规则,只有整行像标题的才算:一行不超过 40 个字、没有句号和分号、最多一个逗号。
| 原文里的标题 | 例子 | 用哪条规则 |
|---|---|---|
| 第X章(中文数字) | 第一百零八章 雪夜、第壹佰零捌章 | 预设 |
| 第X章(阿拉伯数字) | 第108章 雪夜、第108章 | 预设 |
| 第X回、第X卷、卷X | 第十二回、第二卷、卷二 | 预设 |
| 第X节 | 第3节 | 预设,默认不勾:很多书一章里还分节,按节切会太碎 |
| 序章、楔子、番外 | 楔子、番外 雪夜重逢 | 预设 |
| 英文章节 | Chapter 12、Chapter XII、Chapter Twelve | 预设 |
| 只有数字编号 | 108. 雪夜 | 自定义正则 |
| 方括号编号 | 【一】雪夜 | 自定义正则 |
自定义正则:三个能直接改的例子
- 「108. 雪夜」这种数字加点的标题:\d+\.\s*\S+
- 「【一】雪夜」这种方括号编号:【[一二三四五六七八九十百千零〇]+】
- 「第一幕」「第二幕」这种戏剧分幕:第[一二三四五六七八九十百]+幕
自定义正则不用写开头的 ^:工具会自动只匹配一行的开头,英文不分大小写。正文里「他翻到第三章的时候」这种句子,既不在行首、又带着句号,不会被当成标题。写好以后看一眼工具列出的标题清单:数量和目录对得上,再切。
章节标题会被读出来
切好的每一份,第一行通常就是章节标题。贴进工坊后,这一行会当成旁白读出来。想让旁白报章节名就留着;不想要,配音前删掉这一行。
TXT分割器分集前的五个习惯
这几件事做在切之前,能省掉配音时的大部分返工。
先删掉开头的作品信息
网上下载的 TXT 开头常有书名、作者、简介和「本书由某某整理」之类的行。第一个章节标题之前的内容会单独成为第 001 份,配进去旁白会照读:要么打开文件先删掉,要么切完把这一份扔掉。
要转对白,给上限留出余量
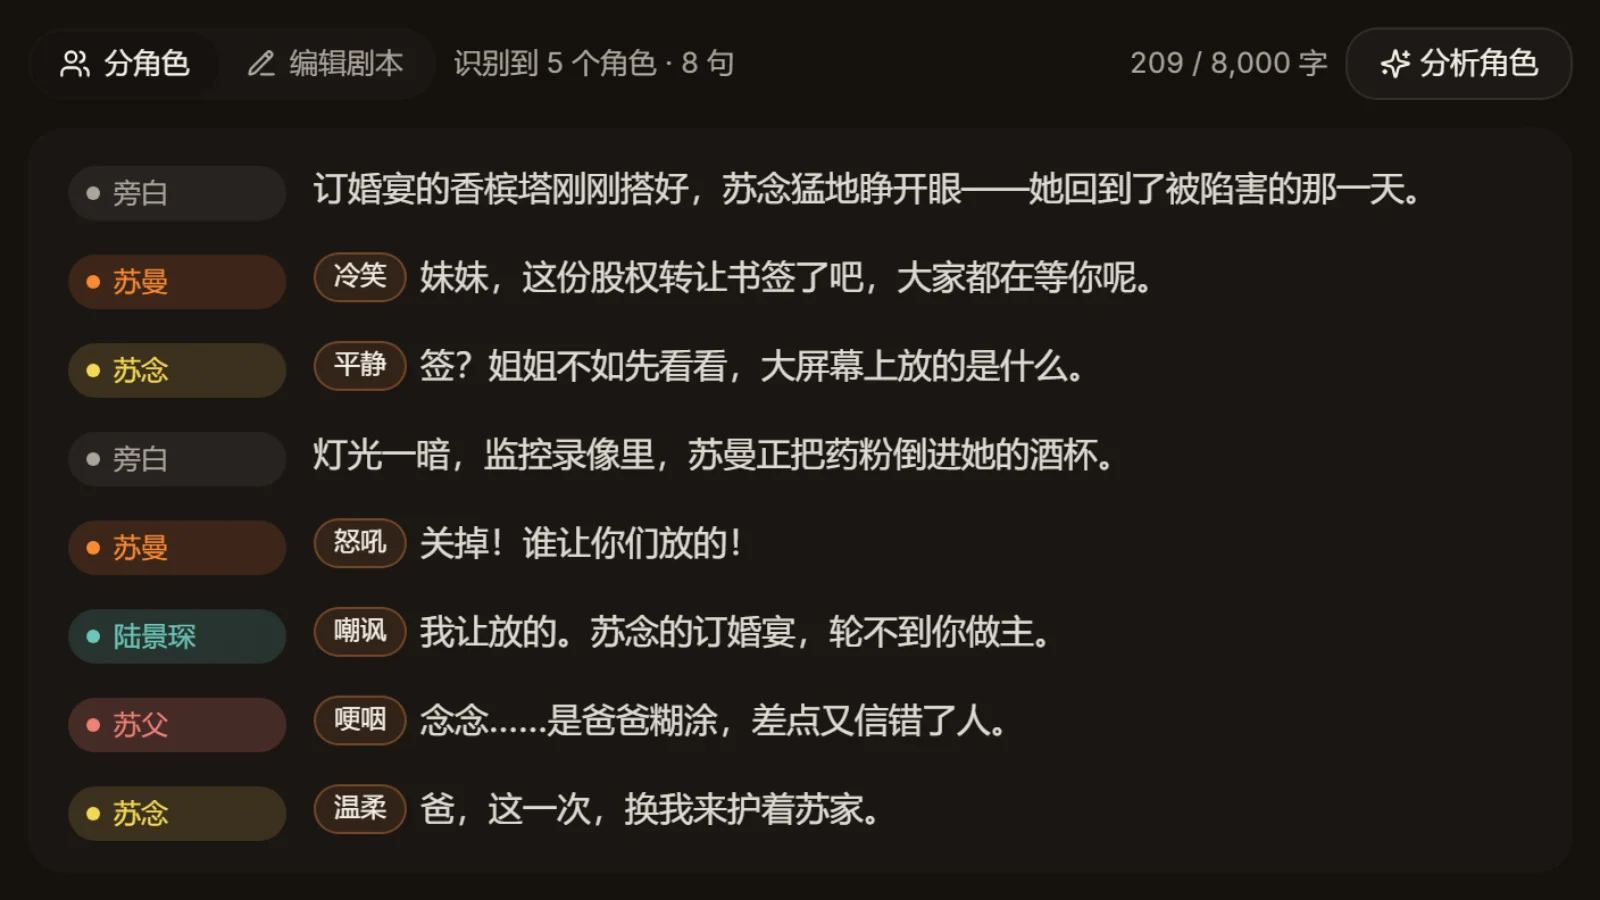
用小说对话提取转成剧本格式以后,每句台词前面多了角色名、冒号和情绪括号,字数会变多。打算转格式的话,把上限设到 7,000 字左右再切,转完不容易超。
对白多的书看行数
结果表里有一份标红,多半是对白太碎、行数先超了。确认 400 行的行数限制是开着的(默认开),再切一次,每份会同时守住字数和行数两条线。
序号就是集数
贴进工坊时按文件名的序号来,项目名也写上集数。到了「我的配音项目」里,一眼就能对上是哪一集。
换书先换规则
不同网站整理的 TXT 标题写法不一样,同一套规则不一定通用。每换一本书,先看一眼识别出来的章节数和目录对不对得上。
常见问题
用本页的 TXT分割器:打开 TXT,选「按章」,工具按「第X章 / 回 / 卷」、序章、楔子、番外、Chapter N 这些预设找出章节标题(「第X节」要手动勾上),列出来给你确认,确认后一章一份打包成 ZIP 下载。要给配音分集,选「按章合并」,短章会并到 8,000 字以内。
先看标题是什么写法:「第X节」默认不勾,勾上就行;只有数字编号(「108. 雪夜」)或方括号编号(「【一】」)不在预设里,写一条自定义正则,本页「章节规则」一节有能直接改的例子。标题一行超过 40 个字、或者带句号,也不会被当成标题。整本书一个标题都没认出来时,工具会自动退回按字数切。
一般不会。按字数分割文本时,TXT分割器优先在段落结尾、其次在句号、问号、叹号、省略号这类句末断开,所以每份会比设定的字数略少一点。只有一句话本身就比上限还长时,才会在逗号处断开,这一份会单独标出来。按章合并时,超长的一章同样在句末拆开。
AI Drama Voice 配音工坊一集最多 8,000 字(不计空格和换行,标点算字)、400 行。TXT分割器默认就用这个上限,结果表同时显示每份的字数和行数,超过 400 行的标红。积分怎么算见定价页。
TXT分割器会自动在 UTF-8、GBK、Big5 之间判断编码,大部分老 TXT 直接就能读对,导出的文件统一是 UTF-8。如果预览里还是乱码,文件用的是更少见的编码:先用记事本「另存为」UTF-8 再打开。字幕文件乱码用字幕乱码修复。
单个 TXT 最大 50 MB。按 GBK 编码算大约是两千五百万字,按 UTF-8 算大约一千七百万字,一般的长篇小说都放得下。处理在你自己的电脑上进行,文件越大,等的时间越长。
不会。TXT分割器在浏览器里读文件、切分和打包,文件不离开你的电脑,不调用 AI,也不需要登录。




